
人工智慧浪潮正加速重構資料中心的設計思維,帶動硬體架構、能源管理與產業分工全面轉型。面對模型規模持續擴張,如何兼顧效能、成本、可靠性與擴充彈性,已成為產業升級的重要課題,也將牽動台灣科技供應鏈的下一波成長機會。
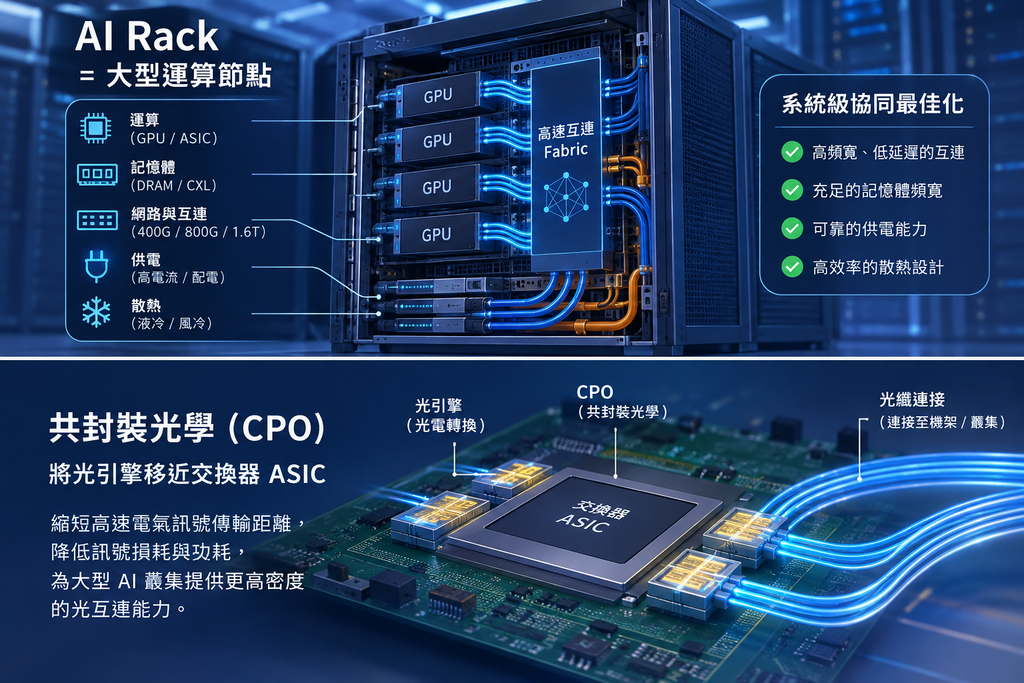
AI運算規模持續擴大,AI Rack(機櫃)正從多台伺服器的集合,演變為整合運算、互連、供電與散熱的大型運算節點。莫仕(Molex)強調,未來AI基礎設施的競爭關鍵,不再只是GPU算力,而是如何透過高速互連、光電整合與系統級設計,將運算資源轉化為更高的整體效率。
生成式AI與大型語言模型快速發展,正重新定義資料中心的設計方式。當數十甚至數百顆GPU必須協同運作,系統效能便不再單純取決於單一處理器的運算能力,而是涉及資料傳輸、記憶體存取、電力供應與散熱管理等多重因素。
AI Rack成為新運算單元,互連效率決定系統效能
AI Rack是否已經應被視為一個大型運算節點,而非多台伺服器的集合?Molex認為,這正是產業正在經歷的轉變。
Molex台灣及南亞銷售副總裁Ricky Chua指出,機架內的運算密度不斷提高,運算、網路、供電與散熱必須以整合式系統的方式共同設計。即使GPU擁有強大的運算能力,若資料無法及時傳輸,或系統受到供電與散熱限制,仍難以充分發揮效能。
下一代AI Rack的競爭焦點,將從單純追求GPU算力,擴展至如何讓大量GPU經由高效率互連Fabric協同運作。這不僅需要高速背板與板對板連接方案,也需要支援400G、800G,並朝1.6T演進的高速I/O互連技術。
在更高資料速率的需求下,Molex亦布局高埠數光電路交換(High-Radix Optical Circuit Switching)與共封裝光學(CPO)等技術,協助提升頻寬密度、降低功耗,並因應大型 AI 叢集日益複雜的互連需求。
記憶體、網路、供電與散熱,瓶頸將更趨系統化
展望AI Factory的發展,Ricky Chua剖析未來的效能瓶頸不會簡單地從GPU轉移至記憶體或網路,而是會逐漸分散至整個基礎設施。
當GPU數量持續增加,記憶體必須更快速地提供資料,網路與互連系統需要承載更高流量,供電與散熱則必須支撐不斷攀升的功率密度。任何一個環節無法配合,都可能限制整體運算產出。
CXL(Compute Express Link)所支援的記憶體一致性與資源共享能力,也為AI伺服器架構帶來新的發展方向。借助記憶體擴充與資源池化(Memory Pooling),系統有機會更彈性地配置記憶體容量,減少資源配置上的限制。不過,實際效益仍取決於工作負載、延遲需求、平台支援及軟體架構,並非所有AI應用都能直接受益。
在散熱方面,高功率GPU與ASIC持續推升液冷需求。Molex於2026年策略性投資CAEPlus,即是著眼於主動式液冷技術的發展,以應對AI與高效能運算帶來的散熱挑戰。此外,多通道液冷匯流排技術將冷卻功能與配電層整合,有助於回應高電流供應與散熱限制彼此交織的系統需求。
這也意味著,未來AI Factory的效能將取決於運算、記憶體、網路、互連、供電與散熱能否協同最佳化,而非單一元件的性能提升。
PCIe 6.0/7.0與CXL:高速互連的關鍵在訊號完整性
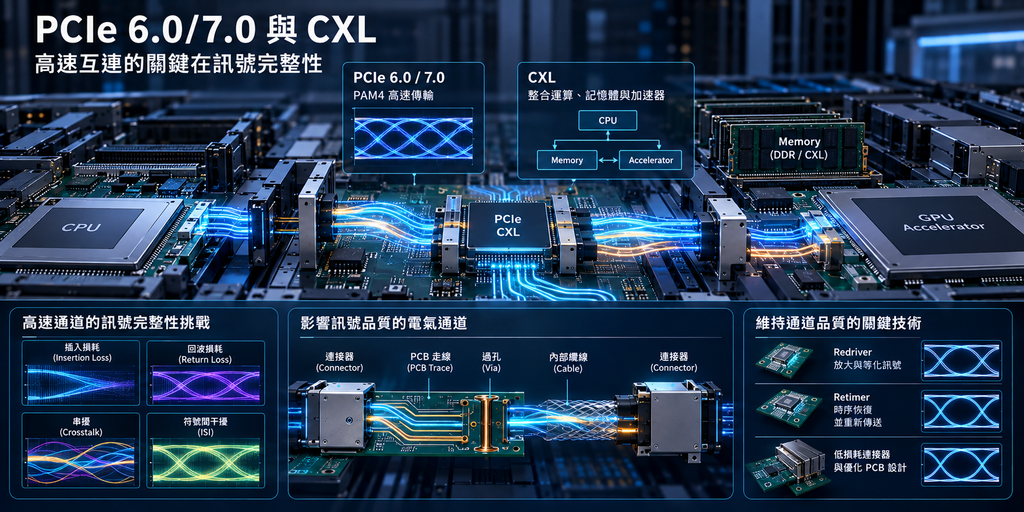
在伺服器內部互連方面,PCIe與CXL將持續扮演重要角色。PCIe 6.0採用PAM4訊號技術提升傳輸效率,而PCIe 7.0則朝更高資料速率發展。CXL則在此基礎上,提供處理器、記憶體與加速器之間更具彈性的資源整合能力。
然而,速率越高,訊號完整性(Signal Integrity, SI)的設計挑戰就越大。插入損耗、回波損耗、串擾及符號間干擾,都可能侵蝕有限的訊號裕量。PCB走線、過孔、連接器與纜線中的每一段電氣通道,都會影響最終的傳輸可靠性。
因此,PCIe/CXL的極限並非只由介面規格決定,更取決於整條通道的設計品質。當傳輸速率提高、系統密度增加,低損耗連接器、最佳化 PCB 轉接設計,以及redriver、retimer 等主動式訊號調節技術,將成為維持通道品質的重要工具。
Molex的NearStack PCIe連接器系統,正是其高速互連產品布局的一環。未來的設計方向,也將從單一連接器的規格競爭,轉向涵蓋連接器、內部纜線與主動式訊號調節的完整通道解決方案。
Retimer、AEC與DSP Cable:高速銅互連持續演進
隨著高速通道從112G邁向224G、甚至更高資料速率,主動式銅纜的角色日益重要。
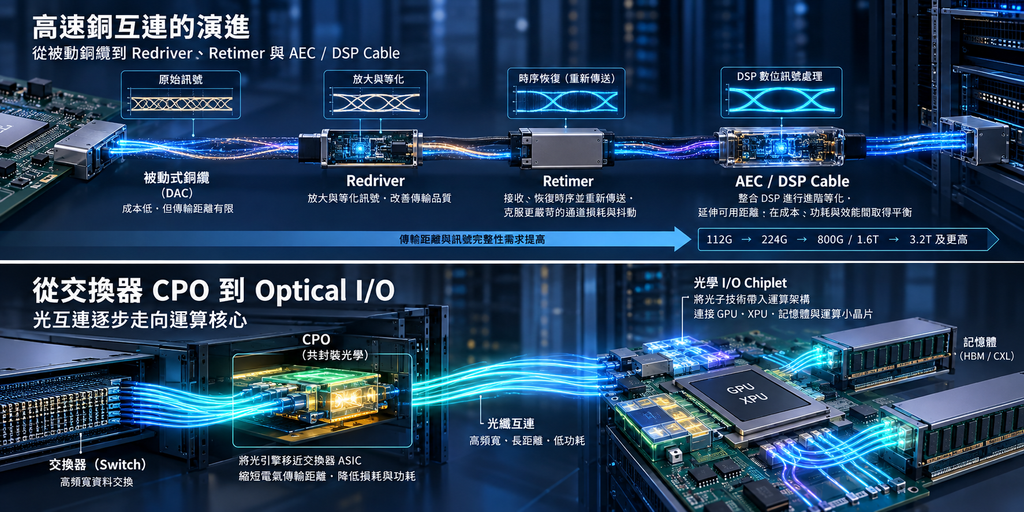
Redriver主要透過訊號放大與等化改善傳輸品質,具備相對簡潔的設計特性;retimer則透過接收、恢復時序並重新傳送訊號,協助克服更嚴苛的通道損耗與抖動問題。至於整合DSP的主動式纜線,則可運用數位訊號處理與等化技術,依產品架構提供更進階的訊號補償能力。
其中,主動式電纜(AEC)在被動式直連銅纜(DAC)與光纖方案之間提供另一種選擇。當被動式銅纜的傳輸距離受到限制時,AEC可經由主動式訊號處理延伸可用距離,並在成本、功耗與傳輸效能之間取得平衡。
Molex相信,在800G、1.6T,甚至未來3.2T世代,銅互連仍將在短距離應用中保有重要地位。不過,實際可支援的距離,仍須視資料速率、纜線設計、功耗限制及系統環境而定。當距離與頻寬需求持續增加,主動式銅纜與光互連將依不同應用場景形成互補,而非由單一技術全面取代另一種技術。
從交換器CPO到Optical I/O,光互連走向運算核心
在光互連領域,Molex預期,CPO將優先在網路交換器等高頻寬需求場景發展。藉由將光引擎移近交換器ASIC,可縮短高速電氣訊號的傳輸距離,降低訊號損耗與部分互連功耗。
相較之下,若將光學元件直接整合至GPU或其他高功率運算晶片附近,則必須面對更複雜的熱管理、封裝、製造良率與維護挑戰。CPO在交換器層級的導入,可望為光電整合技術累積量產經驗,再逐步延伸至更廣泛的Scale-Up架構與運算互連。
長期而言,光學I/O Chiplet有機會將光子技術進一步帶入運算架構,使GPU、XPU、記憶體及運算小晶片之間的高速資料傳輸,逐步突破傳統電氣I/O在功耗與距離上的限制。
Molex收購Teramount將可拆卸式光纖對晶片連接技術納入產品組合,正是意在補強CPO與矽光子架構中的光纖耦合能力。搭配高埠數光電路交換及高密度光纖連接技術,這些布局將有助於支援大型AI叢集所需的光學互連基礎設施。
台灣供應鏈的機會:從元件優勢進階到系統整合
對台灣而言,AI基礎設施的演進不僅是伺服器出貨量增加,更是從元件製造、伺服器ODM到系統整合與資料中心平台的整體升級機會。
GPU密度提高、模組化架構普及,台灣廠商必須同時處理高速互連、訊號完整性、記憶體擴充、供電與散熱等設計挑戰。PCIe、CXL、AEC與光互連技術的發展,也讓連接器與纜線供應商更早介入平台設計,與客戶共同定義整體通道架構。
Molex表示,將透過台灣在地產品管理、現場應用工程與研發團隊,支援客戶在高速電氣互連、光互連、CPO,以及供電與液冷等領域的需求。從AI Rack到AI Factory,產業正在重新思考互連的定位。它不再只是將不同元件連接起來的被動環節,而是影響運算效率、系統擴充性與能源使用效率的核心架構。
當AI基礎設施持續朝高密度、高頻寬與高整合度發展,真正的競爭優勢,將來自能否將運算、記憶體、網路、供電與散熱整合為一套高效率、可擴充且可靠的系統。這也將是下一階段AI基礎設施與互連產業共同面對的關鍵課題。