
生成式AI推動GPU、AI ASIC、高速交換器與光互連需求快速成長,但隨著資料中心規模擴大,電力、散熱與資料傳輸逐漸成為算力擴張的關鍵約束。AI叢集的GPU-to-GPU、GPU-to-Switch與GPU-to-Storage資料交換量同步增加,使高速互連不能只追求更高Gbps,也必須降低每bit傳輸能耗。於是,產業競爭正從「算力最大化」走向「每瓦有效算力最大化」,Gbps/Watt與Effective AI Throughput per MW等指標的重要性也持續提升。
在此背景下,LPO(線性可插拔光學)、NPO(近封裝光學)、CPO(共封裝光學)、矽光子與先進封裝快速發展,核心方向集中在兩件事:降低每bit傳輸能耗,以及縮短高速電訊號的electrical reach(電氣範圍或電氣覆蓋距離)。值得留意的是,光互連並不只有「把單一光通道做得更快」。2026年艾邁斯歐司朗(ams OSRAM)進一步展示以車用microLED技術為基礎的「Slow-and-Wide」架構,嘗試以數百甚至數千個較低速平行光通道,取代單一超高速鏈路,為AI資料中心光互連提供另一種設計思維。
電力約束,正在改寫AI資料中心的效能邏輯
AI基礎設施的瓶頸正從運算能力延伸到電力、散熱與資料傳輸。生成式AI模型規模持續擴大,GPU與AI ASIC運算能力提升,HBM(高頻寬記憶體)容量與頻寬同步增加,小晶片(chiplet)與異質整合也提高資料交換需求。運算單元愈強,單位時間需搬運的資料愈多;若傳輸能源同步上升,新增算力可能被互連與散熱成本抵銷,使電力問題從「機房營運成本」轉為「系統架構問題」。
對資料中心營運商而言,MW正逐漸成為與GPU數量同等重要的資源;對半導體與高速互連產業而言,則意味著「每一瓦可以換回多少有效資料傳輸與運算能力」的重要性提高。這也解釋了800G、1.6T Ethernet、112G/224G-class SerDes、LPO、NPO、CPO、矽光子與先進封裝同步演進:它們都在回答同一個問題——如何讓資料搬得更快,同時避免互連成為新的功耗瓶頸。
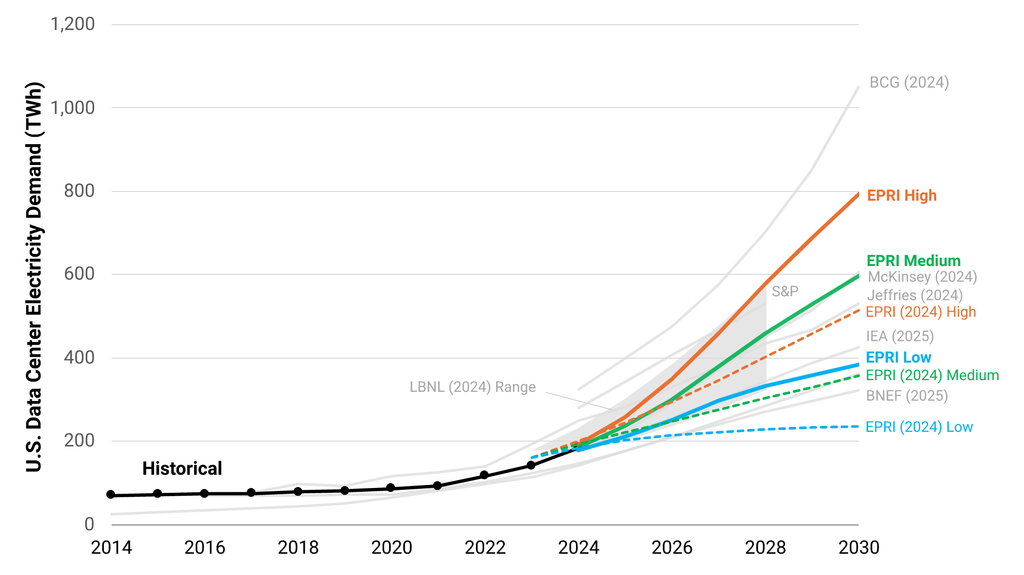
資料來源:EPRI《Powering Intelligence 2026》
資料中心電力需求快速增加,也開始反映在能源政策與電網成本分攤的討論上。2026年9月16日,美國眾議院以417比3通過H.R. 9340《Ratepayer Protection Act》,要求州公用事業監管機構在制定電價政策時,考慮大型負載客戶承擔新增發電、輸電與配電基礎設施的增量成本一案,便可窺得一二。
雖然該法案於9月30日在參議院以57比43的程序性表決未達60票門檻,尚未成為正式法案,短期內不會直接改變800G或1.6T光模組規格,但反映AI資料中心的電力取得成本與負載承諾,正成為資本支出與部署速度的重要變數。若類似政策持續出現,可能影響資料中心選址、併網與擴建,並使高速互連需求從「增加多少連接埠」進一步轉向「每個連接埠消耗多少電」。因此,AI資料中心高速互連正形成新的衡量框架。
224G SerDes:問題不只是速度,而是通道還能不能承受?
AI交換器與加速器的高速I/O持續升級,使224G-class SerDes成為下一階段高速互連的重要技術節點。
IEEE P802.3dj的工作方向,是以200 Gb/s以上的每通道訊號傳輸技術(lane signaling technology)支援200G、400G、800G與1.6T Ethernet;其中1.6T是aggregate Ethernet rate(聚合乙太網路速率或鏈路聚合速率),而非單一SerDes通道傳輸1.6 Tb/s。
在PAM4架構下,每個symbol可承載2 bits;若以約112 GBaud為例,奈奎斯特頻率(Nyquist frequency)約為56 GHz。這使印刷電路板、封裝、導通孔、連接器與電纜等電氣通道,都必須維持足夠的訊號完整性。
須注意的是,56GHz是特定112 GBaud PAM4案例,不代表所有224G SerDes的固定物理頻率;實際架構仍受symbol rate(符號速率或波特率)、編碼、通道實作/等化與標準定義影響。PAM4可在較低symbol rate下取得更高bit rate(位元速率或比特率),但四個電壓電平的判決距離較NRZ(不歸零編碼)小,訊號餘裕(signal margin)也因此縮小。
224G時代的挑戰不只是提高速度,而是在更高Nyquist frequency、更大通道損耗與更小訊號餘裕下維持低BER(位元錯誤率或誤碼率)。因此,競爭也從SerDes晶片擴展至銅箔基板、PCB、封裝、連接器、纜線、主動式電纜(AEC)、SI/PI simulation與高速量測設備。
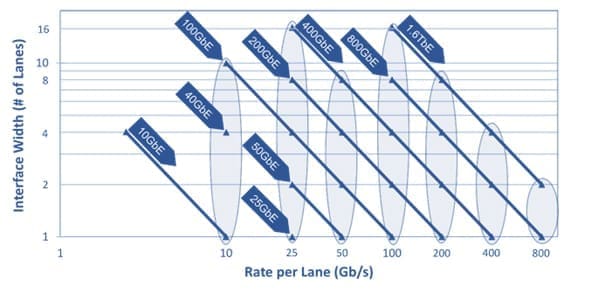
資料來源:IEEE 802.3 / P802.3dj
Full-Retimed、LPO、NPO到CPO:非單一路線,是electrical reach的重新分配
傳統高速光模組通常利用DSP進行大量訊號處理,包括等化、重定時(retiming)以及其他補償功能,使主機ASIC不需要直接承受完整的光電通道挑戰。
這種Full-Retimed架構的優點,是鏈路預算(link budget)較寬、系統互通性與設計彈性較高;但DSP本身也會消耗相當的電力。當800G進一步走向1.6T,功耗與散熱開始成為高密度交換器的重要問題。
所以,LPO開始受到市場關注。LPO的核心並不是單純「把DSP拿掉」,而是移除光模組內的DSP/retiming功能,讓主機SerDes與整體鏈路共同承擔更多等化與訊號完整性要求。LPO MSA目前已將每通道100 Gbps延伸至200 Gbps的方向納入規格發展。
這樣做可以降低模組功耗與延遲,同時保留pluggable optics可熱插拔、可維修與可升級的優勢;但代價是主機電氣通道必須更好,系統也更依賴特定主機SerDes與光學模組之間的配對與驗證。
換句話說:LPO沒有消除高速訊號問題,而是重新分配高速訊號處理的功耗、複雜度與責任。當electrical reach繼續縮短,下一步便是把光引擎進一步往ASIC靠近:NPO將光引擎從前面板移到ASIC附近,縮短高速電氣走線;CPO則進一步把光引擎與ASIC整合到更接近封裝層級的位置。兩者共同邏輯都是降低electrical reach,而不是單純追求更高的光學傳輸速率。
我們可以把不同架構理解為:
⏺︎ Full-Retimed Pluggable(全重定時可插拔收發器):以DSP換取較高的通道容許誤差(channel tolerance)。
⏺︎LPO:以較低功耗換取更高的host channel要求。
⏺︎ NPO:透過縮短PCB上的electrical reach,降低訊號損耗與功耗。
⏺︎CPO:進一步把光互連帶到ASIC封裝附近甚至封裝內。
它們並非簡單的「上一代被下一代淘汰」,而是針對不同距離、功耗、維修性與系統整合條件的架構選擇。
CPO:當電通道走不動,光開始靠近ASIC
CPO並不只是「下一代光模組」,而是高速I/O架構的重新配置。
在傳統可插拔架構中,交換器ASIC與前面板光模組之間仍存在一段高速電氣路徑,當SerDes速率提升,這段距離所產生的插入損耗、等化需求與功耗快速增加。CPO的基本邏輯,就是把光轉換點往Switch ASIC靠近,其價值主要來自三個方向:縮短electrical reach、降低通道損耗與等化負擔,以及提高I/O頻寬密度與電源效率。
Lightmatter的Passage平台即展示了從NPO到CPO的不同整合層級;其L200平台採用3D光子整合,並以區域陣列I/O方式突破傳統晶片I/O受限於晶粒邊緣的「shoreline」瓶頸。
但CPO並不代表pluggable optics必然消失。Pluggable的優勢仍然包括模組化、現場維修與升級彈性;CPO則必須面對封裝良率、熱管理、可靠度、可維修性與供應鏈協同等問題,未來可能形成多架構並存;真正決定架構的不是「誰的頻寬最高」,而是:距離×功耗×頻寬密度×散熱×成本×維修性×系統整合。
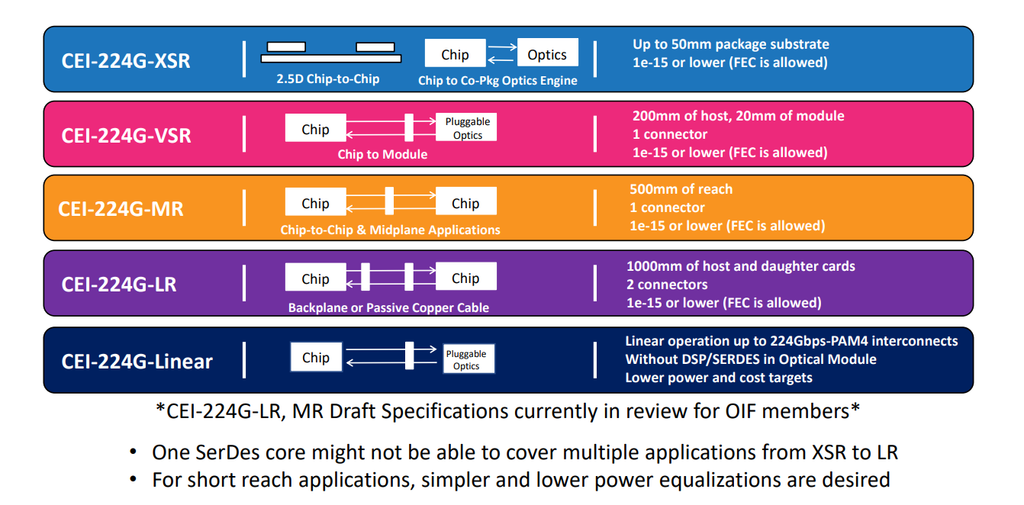
資料來源:OIF、Lightmatter
Slow-and-Wide:microLED帶來另一種光互連設計思維
如果LPO、NPO與CPO主要是在思考「如何讓既有高速光鏈路更靠近ASIC」,microLED則提出另一個更根本的問題:一定要讓每一條光通道都跑得非常快嗎?
目前高速光互連的主流思維,大致可以稱為「fast-and-narrow」:透過提高單一光通道的速率,減少所需要的通道數;例如IEEE P802.3dj正朝每通道200 Gbps及1.6T Ethernet發展。另一種面向是「Slow-and-Wide」:不追求單一通道極高速,而是利用數百甚至數千條較低速的平行光通道,透過大量並行取得更高的聚合頻寬(aggregate bandwidth)。這正是microLED出線的原因。
microLED具有非常小的發光尺寸,可以在有限面積內形成大量獨立控制的發射器。ams OSRAM目前將其車用microLED量產技術延伸至AI光互連,採用單晶化(singulated)microLED,再將個別發射器整合到基板,使其各自耦合至多通道光纖中的獨立光通道。目前公開的測試結果顯示,單一microLED通道在10公尺鏈路下可達至少3.0 Gbps,能耗低於2 pJ/bit,並符合低於10⁻¹⁵的BER要求。
這與224G-class SerDes相比,單通道速率顯然低得多;但Slow-and-Wide的目的本來就不是在單通道速度上競爭,而是用大量低速通道換取:高並行度 × 高頻寬密度 × 低單通道功耗。更重要的是,這種架構可以自然地導入冗餘通道。
當系統包含數百甚至數千個發射器時,單一microLED失效不一定代表整條鏈路失效;若系統預留備用通道(spare channel),就有機會透過「優雅降級」(graceful degradation,是指當部分功能失效、支援環境變差或系統負載過高時,用降低部分效能或次要功能的方式,確保核心功能依然可以運作)維持整體服務。
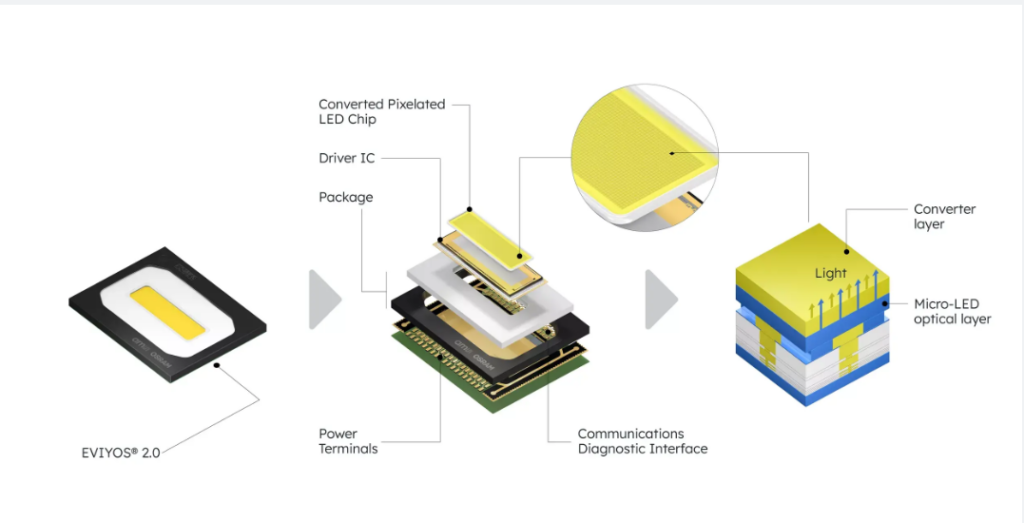
資料來源:ams OSRAM
microLED的真正價值不只是低功耗,而是「架構冗餘」
Slow-and-Wide最令人矚目的地方,不只是microLED本身的pJ/bit,而是它可能改變光互連的系統設計方式。
第一是可靠性。高速窄通道架構通常依賴少數高性能光發射器;當單一關鍵元件故障,其影響可能較大。大量microLED並行架構則有機會透過備用通道與冗餘(redundancy)降低單一元件失效對整體系統的影響。
第二是功耗。ams OSRAM指出,其Slow-and-Wide架構中的microLED發射器可在約1GHz等級的相對低切換頻率下工作,與超高速光發射器相比,有機會降低發射端功耗與熱負載。這裡的「約1GHz」應視為該架構的典型設計描述,而非microLED本身固定的操作頻率。
第三是資料流的並行性。AI加速器本身就具有大量平行資料流,Slow-and-Wide可以讓資料在光學介面維持較高程度的平行處理。這可能降低部分串列器/解串列器(serializer/deserializer)負擔,但這不能簡化為「microLED完全不需要SerDes」;實際系統仍須視主機介面、資料映射與電氣/光學架構而定。
microLED真正有趣的地方,是它可能把光互連的設計問題從:「如何把一條鏈路做得更快?」重新定義為:「如何用大量簡單、低功耗、可冗餘的通道,把整體資料搬得更有效率?」這與CPO所追求的「把光靠近ASIC」其實是兩個不同維度的最佳化。CPO主要最佳化的是空間距離與electrical reach;Slow-and-Wide則更強調通道數、並行度與單通道功耗。兩者未來甚至可能結合。
資料中心光互連需要將microLED從晶圓中切割、分離、安裝到基板,使個別發射器對應獨立光纖通道,最後再與CMOS及光學系統整合。microLED製程能力+大量pixel整合能力+CMOS驅動+高可靠度製造經驗,讓microLED成為高速光互連產業的一條新興供應鏈路徑。
價值鏈重新分配:從SerDes IP一路延伸到microLED
高速互連架構改變後,半導體價值並沒有消失,而是沿著資料傳輸路徑重新分配。
最上游之一,是高速介面IP,包括PCIe、CXL與SerDes PHY,這些IP讓AI ASIC、DPU(資料處理器)、儲存控制器與交換器ASIC具備高速I/O能力。
另一條支線則是Storage Fabric(儲存網格)。儲存控制器位於PCIe/CXL與SSD之間,負責提升資料吞吐、延遲、QoS與能源效率。它與1.6T Ethernet所代表的Network Fabric不是同一個市場,但兩者共享相同的底層趨勢:AI算力越高,資料搬運效率越重要。
高速互連已經不再是一個單一零組件市場,而是一條跨越:IP → ASIC → Package → PCB → Connector → Electrical IC → Optical Engine → Fiber → Testing的完整產業鏈。microLED的出現,則使「光發射器」本身也可能出現不同於傳統VCSEL、EML與矽光子雷射的另一種技術路線。
量測設備:每一次SerDes升速,都需要新的驗證基礎設施
高速互連產業還有一個容易被低估的受惠環節:量測與測試設備。SerDes每提升一個世代,驗證難度也同步增加。高速示波器、BERT、VNA、取樣示波器以及SI/PI模擬工具,都成為高速互連不可缺少的驗證基礎設施。
尤其在224G時代,測試不再只發生在最終產品,而是一路往前延伸。這使高速量測設備不只是產品驗證工具,而是每一次SerDes升速都必須同步投入的「驗證基礎設施」。LPO、NPO、CPO甚至microLED也不會讓這個需求消失。相反地,架構越新,越需要驗證電氣、光學、封裝與系統之間的互通性。
資料來源: Keysight
3.2T之後:高速互連的競爭將從「更快」轉向「更有效率」
當互連速率進一步從224G走向更高世代,單純提高SerDes速度的邊際成本將持續增加。更高的symbol rate意味著更高的Nyquist frequency、更嚴格的channel loss、更小的signal margin,也意味著更多equalization、封裝與散熱壓力。
未來的架構可能不再只有一條答案。一條路徑是繼續提升單通道速率:112G → 224G → 更高速SerDes;另一條路徑則是縮短electrical reach:Pluggable → LPO → NPO → CPO;再往前,則可能出現完全不同的並行思維:Fast-and-Narrow → Slow-and-Wide。
microLED正代表這種Slow-and-Wide方向的早期探索。它不試圖與224G SerDes在單通道速度上競爭,而是利用大量低速、低功耗的光通道,重新思考AI資料中心的I/O架構。ams OSRAM目前已展示10公尺、每通道≥3.0 Gbps、<2 pJ/bit的microLED光互連測試結果,但資料中心的大規模商業部署仍需要進一步驗證。
這也意味著,下一代AI資料中心的互連競爭,最終可能不是「電還是光」、「LPO還是CPO」或「雷射還是microLED」的單選題,而是一個系統最佳化問題。在什麼距離使用電?在哪裡轉成光?光要跑多快?需要多少通道?每bit消耗多少能量?單一元件故障時系統能否繼續運作?這些問題將共同決定下一代AI資料中心的互連架構。
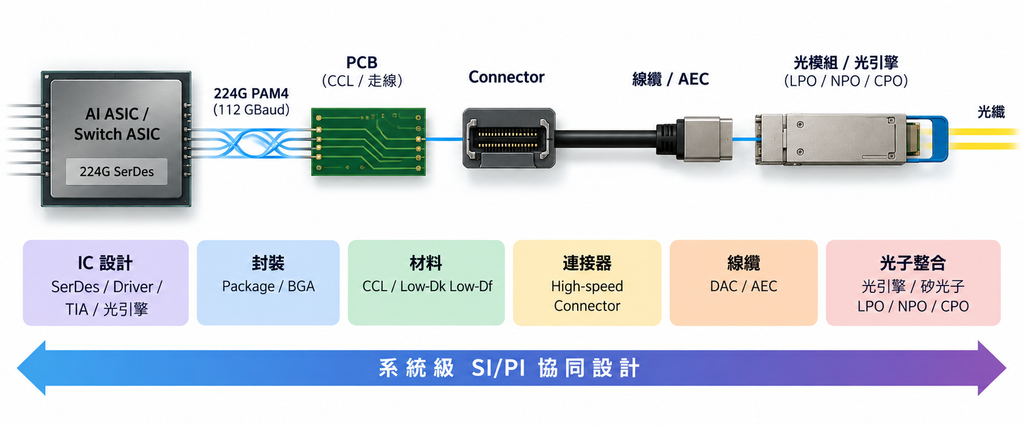
資料來源:筆者繪製
AI互連的下一場競賽,是每一瓦能換回多少有效算力
AI資料中心高速互連正在經歷一次結構性轉變:第一階段,產業關注的是「更高頻寬」;第二階段開始關注「更低功耗」;下一階段則可能進一步轉向:每瓦能夠換回多少有效資料傳輸與AI吞吐量。
這也是為什麼224G SerDes、LPO、NPO、CPO、矽光子與microLED會同時成為市場關注焦點。它們並不是彼此完全替代的技術,而是在不同距離、不同功耗與不同系統整合條件下,嘗試解決同一個核心問題:如何在有限的電力與散熱預算下,把更多資料送到正確的位置。
從這個角度看,AI資料中心高速互連的下一場競爭,不再只是「誰能做到更高Gbps」,而是誰能在頻寬、功耗、距離、可靠度、密度、成本與可維護性之間找到更好的系統解,而這也將使高速互連產業的價值,從單一SerDes或光模組,進一步擴散至IP、ASIC、材料、PCB、封裝、連接器、光引擎、microLED、矽光子以及量測設備。
當算力受到電力邊界限制,互連效率就不再只是工程指標,而會成為AI基礎設施競爭力本身。